Research Topics
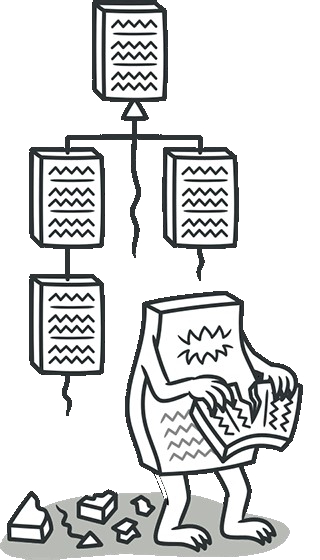
Phát hiện các vấn đề trong thiết kế của mã nguồn
Hướng nghiên cứu:Code Smell – (Mã xấu) thường là các vấn đề tiềm ẩn trong mã nguồn, không phải là lỗi phần mềm nhưng có xu hướng gây cản trở việc tái sử dụng, mở rộng và bảo trì phần mềm trong tương lai. Code smell thường xuất phát từ những vi phạm các nguyên lý thiết kế khi phát triển mã nguồn.
Dự án hướng tới phát hiện các loại code smell khác nhau trong mã nguồn từ comment, source code fragments. Có thể kết hợp cùng với các loại dữ liệu khác đến từ quá trình phát triển và tích hợp liên tục: commit, issue, pull-request. Việc phát hiện sớm các code-smell trong mã nguồn sẽ giúp nhóm phát triển phần mềm lên kế hoạch sớm để làm sạch mã nguồn (clean code) và tinh chỉnh mã nguồn (code refactoring). Một hướng phát triển có thể mở ra khi đã phát hiện được mã xấu đó là tối ưu tài nguyên và thiết lập độ ưu tiên khi tinh chỉnh mã nguồn.
Đối tượng tham gia:Hiện tại với dự án này sinh viên có thể tham gia nghiên cứu cùng các chuyên gia của nhóm nghiên cứu dưới dạng Project 1-2-3, Nghiên cứu tốt nghiệp, Graduation Research 1-2 và Đồ án tốt nghiệp.
Ưu tiên sinh viên có đam mê nghiên cứu, có tinh thần trách nhiệm, nếu có kiến thức nền tảng về NLP, Học máy, Học sâu thì sẽ là lợi thế. Ngoài ra sinh viên nên có kiến thức tốt về nguyên lý các ngôn ngữ hướng đối tượng, các nguyên lý thiết kế (SOLID). Tham gia dự án sẽ giúp sinh viên nâng cao hơn về phần kiến thức nền tảng này.
Phát hiện nợ kỹ thuật (technical debt) trong các dự án phần mềm
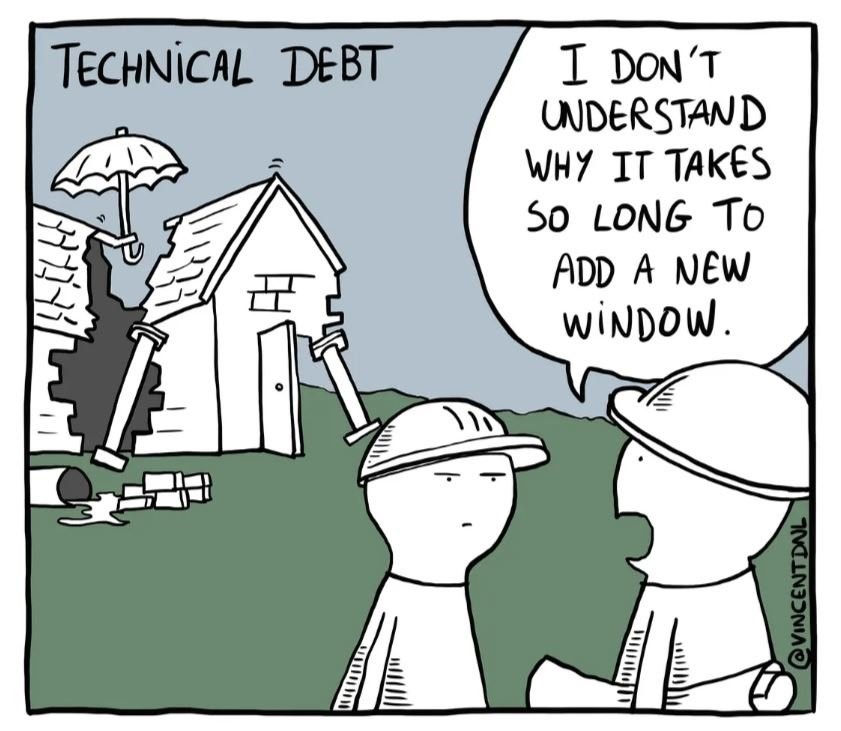
Hướng nghiên cứu:Technical Debt – Nợ kỹ thuật là khái niệm chỉ các giải pháp tạm thời, các đoạn hard code, fixed code, nhằm đáp ứng tiến độ dự án. Có nhiều loại nỡ kĩ thuật khác nhau. Ví dụ design-debt: các đoạn code cần phải tinh chỉnh lại do vi phạm nguyên lý thiết kế, requirement-debt: giải quyết tạm thời một phần của yêu cầu phần mềm hiện tại, có thể phải đối mặt với yêu cầu đầy đủ hơn trong tương lai v.v
Phát hiện nợ kĩ thuật đóng vai trò quan trọng do trong tương lai khi hệ thống phình to hơn, các món nợ này sẽ gây trở ngại có thể phá vỡ các thiết kế hiện tại, khó tái sử dụng, khó mở rộng và thích nghi với thay đổi. Mặt khác do quá trình phát triển dự án phần mềm theo thời gian đội ngũ phát triển có thể có những thay đổi về nhân lực, không phải ai cũng biết về các món nợ trong quá khứ. Do vậy phát hiện sớm nợ kĩ thuật giúp nâng cao chất lượng của mã nguồn và ngăn ngừa rủi ro trong tương lai.
Đối tượng tham gia:Sinh viên tham gia nghiên cứu dưới dạng Project 1-2-3, Nghiên cứu tốt nghiệp, Graduation Research và Đồ án tốt nghiệp.
Ưu tiên sinh viên có đam mê nghiên cứu, có tinh thần trách nhiệm, nếu có kiến thức nền tảng về NLP, Học máy, Học sâu thì sẽ là lợi thế.
Ứng dụng các kĩ thuật xử lý ngôn ngữ tự nhiên trong SE
Hướng nghiên cứu:Chủ đề này bao gồm nhiều bài toán liên quan đến tóm tắt, sinh văn bản, nhận diện thực thể, hệ gợi ý – là các chủ đề truyền thống trong xử lý ngôn ngữ tự nhiên. Tuy nhiên các bài toán này đặt trong bối cảnh của các dữ liệu có liên quan đến phát triển phần mềm.
• Nguồn dữ liệu chủ yếu đến từ Github Repository, nền tảng hỏi đáp Stack-Overflow nơi trao đổi các vấn đề liên quan đến lập trình, phát triển hệ thống, v.v
• Mã nguồn, comment trong mã nguồn và rất nhiều nguồn khác
• Loại dữ liệu này thường là nhiều thể thức (multi-modality) vì dữ liệu sẽ có cả các đoạn text do con người viết (ngôn ngữ tự nhiên), các đoạn mã nguồn (ngôn ngữ lập trình), các thuật ngữ chuyên ngành hoặc API, thư viện… dẫn tới thách thức lớn là làm thế nào để có thể kết hợp, loại bỏ nhiễu, loại bỏ sự dư thừa, không nhất quán hoặc khớp về mặt ngữ nghĩa giữa ngôn ngữ tự nhiên và ngôn ngữ lập trình
• Các bài toán rất đa dạng, hiện tại nhóm đang khai phá các vấn đề liên quan đến tóm tắt, sinh tiêu đề, gợi ý thư viện từ các câu truy vấn và khá nhiều chủ đề khác, sử dụng các mô hình huấn luyện trước, các kĩ thuật làm việc với văn bản, mô hình ngôn ngữ lớn LLM
Đối tượng tham gia:Sinh viên tham gia nghiên cứu dưới dạng Project 1-2-3, Nghiên cứu tốt nghiệp, Graduation Research và Đồ án tốt nghiệp.
Ưu tiên sinh viên có đam mê nghiên cứu, có tinh thần trách nhiệm, nếu có kiến thức nền tảng về NLP, Học máy, Học sâu thì sẽ là lợi thế.
Phát hiện các báo cáo lỗi trùng lặp (Bug Report Duplication)
Hướng nghiên cứu:Trong quá trình phát triển và tích hợp liên tục của phần mềm, các dự án phần mềm sẽ sử dụng các hệ thống quản lý theo dõi bug ví dụ BugHost, Bugzilla v.v. Khi các báo cáo lỗi được thành lập (có thể do người dùng, kĩ sư kiểm thử hoặc kĩ sư phát triển) sẽ được đẩy lên hệ thống. Theo thời gian số lượng báo cáo lỗi sẽ tăng lên, trạng thái của các báo cáo lỗi có thể là mới tạo, đã fix hoặc on-hold v.v. Việc phát hiện các báo cáo lỗi trùng lặp (liên quan đến cùng 1 vấn đề trong quá trình phát triển) hoặc các báo cáo lỗi có liên quan đến nhau sẽ giúp cho các nhà phát triển hệ thống giảm thiểu các công việc liên quan đến đọc báo cáo lỗi, hiểu và sửa lỗi trong mã nguồn.
Ngoài thông tin mô tả của lỗi và các bước để tái hiện lại lỗi thì một số báo cáo lỗi có thể có cả mã nguồn, các đoạn stack-trace sinh ra bởi trình dịch v.v và rất nhiều các siêu thông tin khác (meta-data).
Đối tượng tham gia:Sinh viên tham gia nghiên cứu dưới dạng Project 1-2-3, Nghiên cứu tốt nghiệp, Graduation Research và Đồ án tốt nghiệp.
Ưu tiên sinh viên có đam mê nghiên cứu, có tinh thần trách nhiệm, nếu có kiến thức nền tảng về NLP, Học máy, Học sâu thì sẽ là lợi thế.
Tối ưu tổ hợp
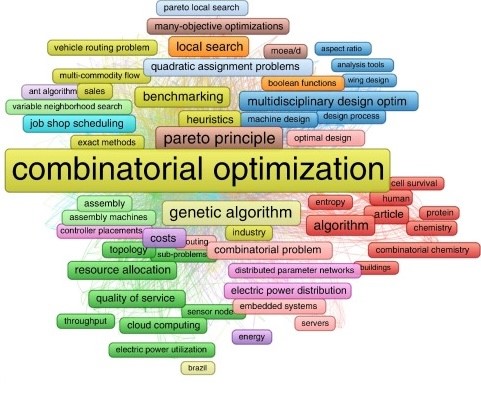
Hướng nghiên cứu:Bài toán tối ưu tổ hợp (Combinatorial Optimization) xuất hiện rất nhiều lĩnh vực của cuộc sống, ví dụ nông nghiệp, sản xuất, tài chính, chuỗi cung ứng, giao vận, giáo dục. Hướng nghiên cứu của truyền thống trong lĩnh vực này gồm:
• Tìm kiếm và mô hình hóa các bài toán tối ưu tổ hợp trong cuộc sống hàng ngày, việc nghiên cứu các bài toán này có ý nghĩa/mang lại giá trị cho xã hội;
• Chứng minh độ khó (NP-hard/NP-complete) của các bài toán tối ưu tổ hợp;
• Đề xuất các mô hình toán học (Integer programming) và quy hoạch ràng buộc (Constraint programming) cho các bài toán;
• Đề xuất các thuật toán chính xác cho bài toán tối ưu tổ hợp;
• Đề xuất các thuật toán kinh nghiệm (tham lam, tìm kiếm cục bộ, tìm kiếm cục bộ dựa trên ràng buộc, tìm kiếm tabu, …);
• Phân tích, đánh giá về hiệu quả các đề xuất;
• Phát triển các thư viện nguồn mở giải các bài toán này phục vụ cộng đồng;
Đối tượng tham gia:Sinh viên tham gia nghiên cứu dưới dạng Project 1-2-3, Nghiên cứu tốt nghiệp, Graduation Research và Đồ án tốt nghiệp.
Ưu tiên sinh viên có đam mê nghiên cứu, có tinh thần trách nhiệm, nếu có kiến thức nền tảng về thuật toán, tối ưu, Học máy sẽ là lợi thế.
Công nghệ tài chính
Hướng nghiên cứu:Ứng dụng các kỹ thuật thuật toán, tối ưu rời rạc trong học máy, dữ liệu lớn, phân tích dữ liệu và tối ưu danh mục, áp dụng trong lĩnh vực tài chính. Các hướng nghiên cứu chính:
• Rời rạc hóa dữ liệu: Việc rời rạc hóa dữ liệu sẽ làm giảm độ phức tạp quá trình huấn luyện các mô hình học máy, tăng độ robustness của mô hình. Hiện tại, nghiên cứu đang tập trung vào rời rạc hóa các đặc trưng (feature) riêng rẽ. Rời rạc hóa đồng thời nhiều đặc trưng, phù hợp với từng thuật toán học máy là một hướng nghiên cứu mở, tiềm năng.
• Lựa chọn đặc trưng: Bài toán lựa chọn đặc trưng là bài toán kinh điển. Tuy nhiên các thuật toán học máy càng ngày càng phát triển. Hướng nghiên cứu tập trung việc lựa chọn đặc trưng phù hợp nhất với từng loại thuật toán học máy.
• Thuật toán học máy: Hướng nghiên cứu tập trung vào điều chỉnh/đề xuất các thuật toán học máy cho các bài toán trong tài chính với hàm mục tiêu là sử dụng hiệu quả nhất trong thực tế thay cho hàm mất mát.
• Xây dựng kho đặc trưng (Feature Store): Các hệ thống MLOps đang được quan tâm trong các tổ chức tài chính, ngân hàng, bảo hiểm. Hạt nhân của các hệ thống này là cá kho đặc trưng. Các giải pháp kho đặc trưng hiện tại của Hopswork, Amazon, Google tập trung vào quản lý các đặc trưng. Hướng nghiên cứu phát triển các engine để trích xuất một lượng lớn các đặc trưng tối ưu dựa các thuật toán hiệu quả và loại bỏ các đặc trưng dư thừa trong kho đặc trưng để tối ưu chi phí.
• Tối ưu danh mục: Các bài toán tối ưu tổ hợp/liên tục trong việc đưa ra các chiến lược marketing, quản trị rủi ro trong các ngân hàng.
• Xây dựng các công cụ tích hợp các kỹ thuật xây dựng mô hình hiệu quả, đơn giản và dễ dùng;
Đối tượng tham gia:Sinh viên tham gia nghiên cứu dưới dạng Project 1-2-3, Nghiên cứu tốt nghiệp, Graduation Research và Đồ án tốt nghiệp.
Ưu tiên sinh viên có đam mê nghiên cứu, có tinh thần trách nhiệm, nếu có kiến thức nền tảng về thuật toán, tối ưu, Học máy sẽ là lợi thế.
Chấm điểm tín dụng
Hướng nghiên cứu:Ứng dụng các kỹ thuật thuật toán, tối ưu rời rạc, học máy, dữ liệu lớn, phân tích dữ liệu và tối ưu danh mục trong xây dựng và vận hành các giải pháp chấm điểm tín dụng. Các hướng nghiên cứu chính:
• Tìm hiểu, phân tích, tổng hợp các bài toán tối ưu tổ hợp trong lĩnh vực chấm điểm tín dụng;
• Áp dụng các kỹ thuật học máy tiên tiến trong bài toán chấm điểm tín dụng dựa trên dữ liệu truyền thống và thay thế;
• Áp dụng các kỹ thuật học sâu trong lĩnh vực chấm điểm tín dụng;
• Áp dụng các kỹ thuật học tăng cường trong lĩnh vực chấm điểm tín dụng;
• Áp dụng các kỹ thuật LLM trong chấm điểm tín dụng, tư vấn giải thích về hoạt động chấm điểm tín dụng;
• Điều chỉnh/đề xuất các thuật toán học máy mới để xây dựng các mô hình chấm điểm tín dụng;
Đối tượng tham gia:Sinh viên tham gia nghiên cứu dưới dạng Project 1-2-3, Nghiên cứu tốt nghiệp, Graduation Research và Đồ án tốt nghiệp.
Ưu tiên sinh viên có đam mê nghiên cứu, có tinh thần trách nhiệm, nếu có kiến thức nền tảng về thuật toán, tối ưu, Học máy sẽ là lợi thế.